Lisez la règle du rampeur avant de la changer. Dans notre échantillon historique, les éditeurs ont écrit des règles différentes pour différents visiteurs liés à l'IA. Cela ne nous indique pas si le propriétaire avait prévu la différence, si une demande a été effectivement bloquée, ou combien de visites ont eu lieu.
Un site Web peut publier robots.txt Le fichier communique des préférences de rampage; ce n'est pas un mot de passe ou un système de contrôle d'accès. Certains sites n'ont pas de fichier lisible. D'autres comptent sur un hôte ou un plugin pour le générer. La première question utile est ce que votre fichier public dit réellement aujourd'hui.
Notre mesure historique a trouvé des règles de rejet au niveau de la racine pour ChatGPT-User en 121 of 1,020 readable files, par rapport à 4 of 1,020 pour OAI-SearchBot. The shares round to 11.9% and 0.4%. A large observed difference is clear; a precise multiple is much less certain because the second count is so small.
Documentation de l'OpenAI, cochée le 25 octobre 2026, distingue la recherche, la formation et la récupération déclenchée par l'utilisateur. OAI-SearchBot prend en charge les résultats de recherche ChatGPT. ChatGPT-User gère certaines visites demandées par l'utilisateur et n'est pas le contrôle pour l'inclusion de la recherche; les règles des robots ne s'appliquent pas à ces demandes.
Cet article sépare l'échantillon original de l'actuel guide d'exploitation. L'ensemble de données n'a pas été réajusté ou réajourné dans le cadre de cette mise à jour éditoriale. outil de politique des rampeurs pour inspecter une politique publique, puis vérifier les journaux de bord ou de serveur si votre question concerne des requêtes réelles.
Combien plus souvent, exactement
121 of 1,020 files against 4 of 1,020. Divide those and you get 30, which is the best single guess and is nowhere near as solid as it looks, because it rests on a denominator of four files.
So here is what we can actually stand behind. Take the 1,020 files, draw 1,020 of them back out at random with repeats allowed, count both crawlers again, and do that twenty thousand times. That is a way of asking what this measurement would have said if a different thousand publishers had been picked, and it assumes nothing about the two counts moving together — which matters, because they are counts over the same files, and three of the four sites that block OAI-SearchBot bloc ChatGPT-User as well. Nineteen times in twenty, the answer lands between 14.5 et 134. Dans un exemple sur cinquante, aucun site à tous les blocs OAI-SearchBot et le multiple n'a pas de sommet.
Une deuxième méthode, qui ne partage aucune hypothèse avec la première: prendre l'intervalle chaque pourcentage est connu séparément et diviser le bas de l'un par le haut de l'autre. 9.9 à 127.
One method gives a lower limit above ten; the other gives 9.9, which is close to ten but does not literally clear it. The defensible summary is a large difference with an uncertain ratio. The observed shares and raw counts carry that finding better than a sharp multiple. A point estimate near 30 is not an exact population result.
À quoi ressemble l'échantillon entier
| of 1,020 we could read | première mesure, de 106 | |
|---|---|---|
| Ne dites rien sur les rampeurs d'IA | 76.1% | 76% |
| Bloc au moins un | 21.2% | 23% |
| Bloquer un nom lié à la réponse dans la classification originale | 12.1% | 14% |
| Nommez un rampant et laissez passer de toute façon | 2.7% | 1% |
| Nommez un agent absent de la liste de référence utilisée | 16.4% | 16% |
| Nom des agents seulement absents de cette liste de référence | 2.3% | 1% |
| Porter le libellé qu'un fournisseur a mis là | 29.9% | 34% |
Et par rampeur :
Faites glisser ou faites défiler la table horizontalement pour voir chaque colonne.
| Crawler | Ce qu'il fait | Bloqué par | 19 fois en 20 |
|---|---|---|---|
GPTBot | Recueille des pages pour former un modèle | 20.2% | 17.8–22.8% |
CCBot | Recueille des données publiques sur les rampes; les utilisations en aval varient | 19.7% | 17.3–22.3% |
ChatGPT-User | Récupération de page déclenchée par l'utilisateur | 11.9% | 9.9–14.0% |
Google-Extended | Token pour des utilisations spécifiques de formation et de mise à la terre Gemini | 8.7% | 7.1–10.6% |
ClaudeBot | Recueille des pages pour former un modèle | 7.3% | 5.7–9.0% |
PerplexityBot | Recherche découverte et indexation | 0.7% | 0.3–1.4% |
OAI-SearchBot | Recherche découverte et indexation | 0.4% | 0.1–1.0% |
Claude-User | Récupération dirigée par l'utilisateur | 0.2% | 0.0–0.7% |
Claude-SearchBot | Recherche découverte et indexation | 0.2% | 0.0–0.7% |
La dernière colonne est l'intervalle à laquelle chaque figure est vraiment connue. C'est la raison pour laquelle les quatre rangées en bas doivent être lues comme "presque personne", et non comme un ordre.
Ce qui a changé et ce qui n'a pas changé
Cela a été publié pour la première fois le 2026-09-01 à partir de 106 fichiers, récupérés un à la fois. Depuis, notre propre rampeur a lu le même genre de fichier chaque soir, de sorte que la même question pourrait être posée à nouveau de presque dix fois plus d'éditeurs sans demander quelque chose de nouveau.
Nothing turned over. The headline share — publishers with no rule at all — moved from 76% to 76.1%. The two figures that moved most, supplier wording from 34% to 29.9% and the historical answer-related category from 14% to 12.1%, both moved less than the first sample's own margin of error, which was about eight points wide.
What did change is precision. At 106 files these shares were known to within roughly eight points; at 1,020 they are known to within two or three.
Et le multiple en haut de cette note a disparu. 15× — 15 files of 106 against 1 of 106 — which is the right division of the right counts and still should not have been printed, because the denominator was a single file. At 1,020 files the point estimate is 30 and the range runs from about 10 to well over 100, so 15 is inside a wide uncertainty interval, rather than disproved by the larger sample. Neither point estimate deserves a precise, universal headline. A number that survives being divided correctly can still be a number nobody should have stated, and the tell was in the first sample all along: 1 of 106 has a range of 0% to 5%, and no ratio built on it could have been worth two significant figures.
Le chèque que nous devions faire en premier, et presque se tromper
Un plus grand échantillon n'est meilleur que s'il s'agit d'un échantillon de la même chose.
Notre rampeur travaille à travers sa liste le moins récemment essayée d'abord, donc lire "tout ce qu'il a recueilli jusqu'à présent" est un échantillon de qui il est arrivé à atteindre, ce qui n'est pas aléatoire par rapport à quoi que ce soit. Un premier passage sur ce même magasin tenait 597 fichiers d'éditeurs où tous 597 provenaient de l'un des deux réseaux publicitaires et aucun de l'autre. Cela est invisible dans un total. Il aurait publié un des clients d'un réseau comme la liste complète.
So this measurement does not read everything in the store. It reads only the 1,200 domains that were drawn once, in advance, with each network given its share of the list, and only the files collected on a single day when all 1,200 were tried. Eleven other files in the store are readable and were left out because they are not part of that draw. All eleven are from one network, and all eleven say nothing about AI crawlers — so including them would have nudged the headline upwards using files that nothing chose at random.
Il importe plus ici qu'il ne le serait habituellement, car les éditeurs des deux réseaux diffèrent vraiment : 88% des fichiers de l'un d'entre eux ne disent rien sur les rampeurs d'IA, contre 60% de l'autre. Re-pondération de sorte que chaque réseau compte pour sa part de la liste complète, plutôt que sa part des fichiers qui nous ont répondu, déplace chaque chiffre dans le tableau ci-dessus de moins d'un demi-point.
Pourquoi les chiffres sortent de cette façon
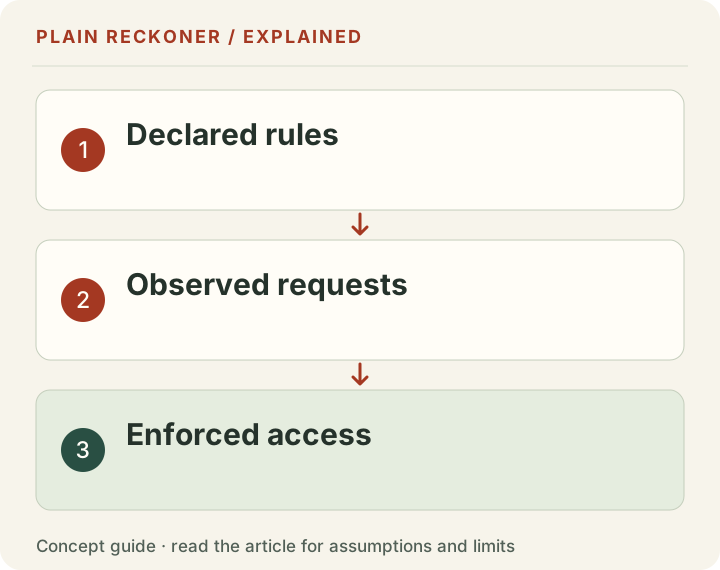
Près d'un tiers des fichiers historiques portaient un libellé conforme à un modèle de fournisseur, comme un bloc publicitaire ou une liste générée par un plugin. C'est une preuve du texte, pas de l'état d'esprit de l'éditeur. Le propriétaire peut l'avoir accepté délibérément, délégué la décision, ou l'avoir négligé. Nous n'avons pas interviewé les propriétaires, donc nous ne pouvons pas distinguer ces possibilités.
The historical classification found at least one name absent from the provider reference list in 16.4% of files. In 2.3%, every explicitly named AI-related agent fell into that category. Absence from a reference list is a reason to investigate, not proof that no client anywhere uses the name or that a rule can have no effect. Current provider names and a historical classification need separate dates.
La partie qui est facile de se tromper
Le nom d'un rampant ne l'empêche pas.
Le fichier est lu en blocs. Un bloc est une ou plusieurs lignes qui nomment des rampeurs, suivies des règles qui s'appliquent à eux — et les règles ne démarrent qu'une fois que le jeu de noms se termine. Le standard qui définit cela, RFC 9309, le met clairement: un groupe peut nommer plusieurs agents avant que ses règles ne commencent. Spécifications RFC 9309 définit la façon dont les groupes et les chemins correspondants sont interprétés.
So a file that stacks thirty crawler names on top of one permissive rule has permitted all thirty. It reads as a wall and works as an open door. 2.7% of this sample does exactly that with at least one crawler.
C'est pourquoi les chiffres ci-dessus sont établis plutôt que comptés. User-agent: GPTBot aurait signalé ces fichiers comme étant le plus strict quand ils sont le contraire — et c'est l'erreur que quiconque vérifie son propre fichier par oeil fera.
Que faire, s'il y a quelque chose à faire?
Il y a une vraie décision ici et ce n'est pas celle que les modèles prennent.
Faites des choix séparés pour la formation de modèle, la recherche découverte et un utilisateur demandant à un assistant d'ouvrir une page. Ces fins peuvent utiliser différents contrôles. Vérifiez la terminologie actuelle du fournisseur plutôt que d'assumer chaque nom contenant -AI-.
Par exemple, La référence de Google pour les crawler explique que Google-Extended est un produit jeton, pas un visiteur HTTP séparé. Son Gemini indiqué utilise diffèrent de Google Search inclusion et de classement. Une liste de noms dans un fichier ne peut pas montrer quelles requêtes ont atteint votre serveur.
Un autre éditeur peut choisir une restriction plus large. Ni le choix ne garantit un renvoi, un paiement, un accord de licence ou l'enlèvement de matériel déjà utilisé ailleurs. Notre mesure ne détermine pas quelle politique est la meilleure pour vous.
Utiliser la espace de travail pour l'analyse libre Lire la politique publique, identifier qui contrôle chaque section gérée, et conserver une copie avant de changer quoi que ce soit. Un tableau de bord d'hébergement peut faire appliquer des règles qui ne sont pas visibles dans le fichier, donc un examen complet nécessite à la fois la déclaration et la configuration de service réelle.
Limites
Les Ensemble de données sur les politiques en matière de crawler publiées Les références actuelles des fournisseurs dans cet article ont été vérifiées le 25 octobre 2026, ce qui ne permet pas de rafraîchir l'ensemble de données.
This is 1,020 readable files, from a sample of 1,200 drawn with a fixed starting word from a list of 16,076 domains that two ad networks publish as their own publishers. It describes small, ad-funded content businesses and nothing more. It does not establish the behavior of publishers outside those networks, enterprise news organizations, stores or the wider web. We have not surveyed every other published study or established that all large publishers behave differently.
180 of the 1,200 gave us nothing we could read. They are left out rather than counted as permitting everything, because a refusal — an HTTP 403, which 107 of them gave — is a fact about a firewall and not about a policy, and counting them the other way would have moved the headline in the direction that flatters it. Ten of the 180 answered normally with an empty file; those are left out too, on the same rule the first measurement used, and counting them as silent instead would put the headline share at 76.3% rather than 76.1%.
La liste que nous avons tirée est celle des éditeurs sur deux réseaux publicitaires, et non sur le web. Un éditeur sans réseau publicitaire n'y est pas.
Ce que nous avons mesuré, c'est ce que disent les fichiers, pas ce qui se passe ensuite.
Cela compte les règles écrites dans les dossiers. Il ne mesure pas si une compagnie d'IA leur obéit, et l'un d'eux dit clairement qu'il ne peut pas.
Les descriptions actuelles des fournisseurs distinguent l'extraction déclenchée par l'utilisateur de la découverte automatique. Une règle écrite de refus peut ne pas être le contrôle efficace pour chaque visite demandée par l'utilisateur. Cela ne change pas le texte observé dans les fichiers historiques; cela change les conséquences que nous pouvons raisonnablement en déduire.
En particulier, le fait d'autoriser une fouille n'est pas une garantie de lien ou de visite. Le blocage d'une fouille n'établit pas que l'accès à l'IA s'est arrêté. Une fouille peut également être évitée par un pare-feu même lorsque robots.txt apparaît permissif. Ce sont des observations différentes et nécessitent des preuves différentes.
Un véritable changement de plateforme qui rend la distinction utile
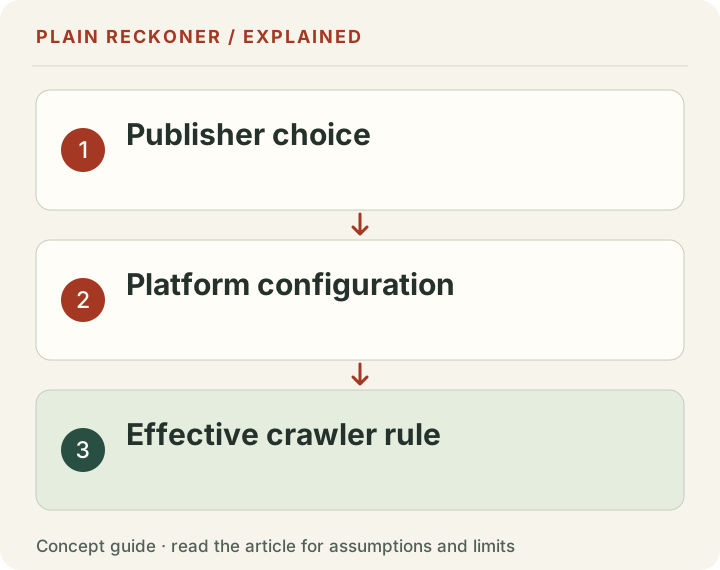
Cloudflare's gestion de la documentation robots.txt, mis à jour le 22 octobre 2026, décrit les directives gérées générées par les préférences de Search, Agent et Training via Bot Preference Sync. Ceci est un exemple actuel d'une plate-forme transformant une préférence de tableau de bord en texte public. Cela ne signifie pas que les signatures historiques des fournisseurs dans notre ensemble de données proviennent de cette fonctionnalité particulière.
La leçon d'exploitation est d'inspecter le fichier servi, non seulement la copie dans votre dépôt de code. Une section gérée peut être ajoutée avant le texte de votre origine. Inversement, une configuration all-allow peut laisser le fichier d'origine inchangé. La source de vérité pertinente pour un rampeur est la réponse qu'il reçoit, ainsi que le comportement documenté du fournisseur et toute règle d'accès imposée séparément.
N'enlevez pas un bloc géré aveuglément. Identifiez le paramètre qui le produit, décidez s'il reflète votre préférence, et faites le changement dans le système qui le possède. Modifier un fichier d'origine peut laisser intacte une section gérée par les bords. Modifier un fichier généré à la main peut également être inversé par la prochaine mise à jour du plugin ou de la plateforme.
Tester une politique déclarée sans réclamer un résultat de trafic
Commencez par une URL publique que les lecteurs devraient pouvoir accéder. Enregistrez la réponse actuelle des robots, son statut, la date et le système que l'on croit gérer. Vérifiez le chemin racine et un chemin d'article réel. Une recherche au niveau racine est utile, mais une règle de chemin plus étroit peut changer la réponse pour une page individuelle.
Si l'objectif est la recherche découverte, utilisez le contrôle de recherche du fournisseur. Si l'objectif est une formation spécifique opt-out, utilisez le contrôle de formation documenté. Évitez de traduire un objectif d'affaires large directement dans une longue liste copiée à partir d'un dépôt aléatoire.
Lisez le résultat comme le ferait un rampleur. Sélectionnez le groupe d'agents pertinent, appliquez ses règles de chemin et notez toute incertitude. Un fichier contenant un nom n'est pas automatiquement un bloc. Un chemin autorisé n'est pas la preuve qu'une requête a été faite. Préservez la réponse brute et votre interprétation afin que quelqu'un d'autre puisse reproduire la vérification.
Après un changement, récupérer le fichier servi à nouveau. Vérifiez les sections gérées en double et les restrictions involontaires sur les rampeurs de recherche ordinaires. Demandez au propriétaire de la plateforme d'expliquer une règle que vous ne pouvez pas tracer. Ne promettez pas un changement de classement immédiat: un rampeur doit encore revoir, et la découverte ne garantit pas la sélection pour une réponse.
Pour l'application effective, inspecter les enregistrements de requêtes serveur ou de bord avec la méthode de vérification bot appropriée. Une chaîne utilisateur-agent peut être imitée. Référence CCBot de Crawl commun La même distinction générale est importante lorsqu'un tableau de bord indique le trafic en utilisant uniquement un nom de visiteur revendiqué.
Tenir le rôle du fournisseur dans un petit registre de maintenance
Enregistrez le nom du robot, le but indiqué, la documentation officielle, la date vérifiée, la décision actuelle et la personne ou le système responsable de la modification. Gardez l'observation historique dans une colonne séparée. Cela empêche le nouveau terme d'un fournisseur de réécrire silencieusement ce qu'un ancien échantillon a mesuré.
Le guide de l'anthrope distingue la collection de développement de modèles, la recherche dirigée par l'utilisateur et la recherche découverte. Le guide de la perplexité Leurs descriptions actuelles sont des contrôles utiles à consulter, et non des preuves que chaque requête historique obéissait à un fichier.
Consultez le registre lorsqu'un fournisseur modifie sa documentation, lorsque votre plateforme d'hébergement change de paramètres gérés ou lorsque des requêtes observées ne correspondent pas à vos attentes. Ne traitez pas une ancienne liste de rampeurs comme une limite de sécurité permanente. Une petite liste datée de choix que vous comprenez est plus utile qu'une longue liste sans propriétaire.
L'étape suivante consiste à inspecter votre propre politique déclarée et à identifier une incertitude qui mérite d'être résolue. Notre échantillon historique peut montrer qu'il existe des déclarations non cohérentes. Il ne peut pas décider de votre position en matière de licence, prévoir une visite ou remplacer des preuves provenant du système qui sert réellement vos pages.