Lea la regla real de los rastreadores antes de cambiarla. En nuestra muestra histórica, los editores escribieron diferentes reglas para diferentes visitantes relacionados con la IA. Eso no nos dice si el propietario pretendía la diferencia, si una solicitud fue realmente bloqueada, o cuántas visitas resultaron.
Un sitio web puede publicar robots.txt archivo en su raíz. El archivo comunica preferencias de rastreo; no es una contraseña o un sistema de control de acceso. Algunos sitios no tienen un archivo legible. Otros confían en un host o plugin para generarlo. La primera pregunta útil es lo que su archivo público dice hoy en día.
Nuestra medida histórica encontró reglas desactivadas a nivel raíz para ChatGPT-User en 121 of 1,020 readable files, en comparación con 4 of 1,020 para OAI-SearchBot. The shares round to 11.9% and 0.4%. A large observed difference is clear; a precise multiple is much less certain because the second count is so small.
Documentación de los rastreadores de OpenAI, comprobado el 25 de octubre de 2026, distingue la búsqueda, entrenamiento y recuperación de usuarios. OAI-SearchBot admite los resultados de búsqueda de ChatGPT. ChatGPT-User maneja algunas visitas solicitadas por el usuario y no es el control de la inclusión de búsqueda; las reglas de robots pueden no aplicarse a esas solicitudes. Ambas descripciones son más precisas que decir que un visitante envía lectores mientras que las otras meramente almacena páginas.
Este artículo separa la muestra original de la guía de operación actual. El conjunto de datos no ha sido repetida o re-dated como parte de esta actualización editorial. Herramienta de arrastre-policía para inspeccionar una política pública, a continuación, comprobar el servidor o los registros de bordes si su pregunta se refiere a solicitudes reales.
Cuanto más a menudo, exactamente
121 of 1,020 files against 4 of 1,020. Divide those and you get 30, which is the best single guess and is nowhere near as solid as it looks, because it rests on a denominator of four files.
So here is what we can actually stand behind. Take the 1,020 files, draw 1,020 of them back out at random with repeats allowed, count both crawlers again, and do that twenty thousand times. That is a way of asking what this measurement would have said if a different thousand publishers had been picked, and it assumes nothing about the two counts moving together — which matters, because they are counts over the same files, and three of the four sites that block OAI-SearchBot bloque ChatGPT-User también. Diecinueve veces en veinte, la respuesta aterriza entre 14.5 y 134. En un resplandor en cincuenta, no hay sitio en todas las cuadras OAI-SearchBot y el múltiple no tiene un extremo superior.
Un segundo método, que no comparte ninguna suposición con el primero: tomar el rango cada porcentaje es conocido por separado y dividir el extremo bajo de uno por el extremo alto del otro. Eso es deliberadamente demasiado ancho, y da 9.9 a 127.
Un método da un límite inferior por encima de diez; el otro da 9.9, que está cerca de diez pero no lo aclara literalmente. El resumen defensible es una gran diferencia con una relación incierta. Las acciones observadas y los recuentos brutos llevan que encontrar mejor que un múltiple agudo. Una estimación de puntos cerca de 30 no es un resultado de población exacto.
¿Cómo es toda la muestra?
| of 1,020 we could read | de 106 | |
|---|---|---|
| No digas nada sobre los rastreadores de IA | 76.1% | 76% |
| Bloqueo al menos uno | 21.2% | 23% |
| Bloquear un nombre relacionado con la respuesta en la clasificación original | 12.1% | 14% |
| Nombra un rastreador y déjalo pasar de todos modos | 2.7% | 1% |
| Nombre un agente ausente de la lista de referencia utilizada entonces | 16.4% | 16% |
| Nombre sólo los agentes ausentes de esa lista de referencia | 2.3% | 1% |
| Carry wording un proveedor puesto allí | 29.9% | 34% |
Y por rastreador:
Desliza o desplaza la tabla horizontalmente para ver cada columna.
| Crawler | ¿Qué hace? | Bloqueado por | 19 veces en 20 |
|---|---|---|---|
GPTBot | Recoge páginas para formar un modelo | 20.2% | 17.8–22.8% |
CCBot | Recopila datos de los rastreos públicos; usos de aguas abajo varían | 19.7% | 17.3–22.3% |
ChatGPT-User | Retrieval de la página desencadenada por el usuario | 11.9% | 9.9–14.0% |
Google-Extended | Token for specified Gemini training and grounding uses | 8.7% | 7.1–10.6% |
ClaudeBot | Recoge páginas para formar un modelo | 7.3% | 5.7–9.0% |
PerplexityBot | Búsqueda de descubrimiento e indexación | 0.7% | 0.3–1.4% |
OAI-SearchBot | Búsqueda de descubrimiento e indexación | 0.4% | 0.1–1.0% |
Claude-User | Retrieval dirigido por usuarios | 0.2% | 0.0–0.7% |
Claude-SearchBot | Búsqueda de descubrimiento e indexación | 0.2% | 0.0–0.7% |
La última columna es el rango que cada figura es realmente conocido. Es la razón por la que las cuatro filas inferiores deben ser leídas como "casi nadie", y no como un pedido.
Lo que la remesurabilidad cambió, y lo que no
Esto fue publicado por primera vez en 2026-09-01 de 106 archivos, uno a la vez. Desde entonces nuestro propio rastreador ha estado leyendo el mismo tipo de archivo cada noche, por lo que la misma pregunta se podría hacer de nuevo de casi diez veces más que muchos editores sin hacer a nadie por nada nuevo.
Nothing turned over. The headline share — publishers with no rule at all — moved from 76% to 76.1%. The two figures that moved most, supplier wording from 34% to 29.9% and the historical answer-related category from 14% to 12.1%, both moved less than the first sample's own margin of error, which was about eight points wide.
What did change is precision. At 106 files these shares were known to within roughly eight points; at 1,020 they are known to within two or three.
Y los múltiples en la parte superior de esta nota se han ido. 15× — 15 files of 106 against 1 of 106 — which is the right division of the right counts and still should not have been printed, because the denominator was a single file. At 1,020 files the point estimate is 30 and the range runs from about 10 to well over 100, so 15 is inside a wide uncertainty interval, rather than disproved by the larger sample. Neither point estimate deserves a precise, universal headline. A number that survives being divided correctly can still be a number nobody should have stated, and the tell was in the first sample all along: 1 of 106 has a range of 0% to 5%, and no ratio built on it could have been worth two significant figures.
El cheque que teníamos que hacer primero, y casi se equivocaba
Una muestra más grande es sólo mejor si es una muestra de la misma cosa.
Nuestro rastreador trabaja primero a través de su lista con menos retroceso, por lo que leer "lo que haya recogido hasta ahora" es una muestra de quien pasó a llegar, que no es aleatorio con respecto a nada. Un pase anterior en esta misma tienda tenía 597 archivos de editor donde los 597 vinieron de una de las dos redes de anuncios y ninguna de las otras. Eso es invisible en un total. Habría publicado a los clientes de una red como toda la lista.
So this measurement does not read everything in the store. It reads only the 1,200 domains that were drawn once, in advance, with each network given its share of the list, and only the files collected on a single day when all 1,200 were tried. Eleven other files in the store are readable and were left out because they are not part of that draw. All eleven are from one network, and all eleven say nothing about AI crawlers — so including them would have nudged the headline upwards using files that nothing chose at random.
Importa aquí más de lo que normalmente lo haría, porque los editores de las dos redes difieren genuinamente: el 88% de los archivos de uno de ellos no dicen nada sobre los rastreadores de IA, contra el 60% del otro. Re-peso para que cada red cuente por su parte de la lista completa, en lugar de su parte de los archivos que nos respondieron, mueve cada figura en la tabla anterior por menos de medio punto.
¿Por qué los números salen así?
Casi un tercio de los archivos históricos llevaban texto consistente con una plantilla de proveedor, como un bloque ad-network o una lista generada por plugins. Esto es evidencia sobre el texto, no el estado de ánimo del editor. El propietario puede haber aceptado deliberadamente, delegó la decisión, o pasó por alto. No entrevistamos a los propietarios, por lo que no podemos distinguir esas posibilidades.
La clasificación histórica encontró por lo menos un nombre ausente de la lista de referencia del proveedor en 16.4% de los archivos. En 2.3%, cada agente relacionado con la IA llamado explícitamente cayó en esa categoría. La ausencia de una lista de referencia es una razón para investigar, no prueba de que ningún cliente utiliza el nombre o que una regla no puede tener ningún efecto.
La parte que es fácil de equivocarse
No lo bloquean.
El archivo se lee en bloques. Un bloque es una o más líneas que nombran a los rastreadores, seguido de las reglas que se aplican a ellos - y las reglas sólo comienzan una vez que el funcionamiento de nombres termina. El estándar que define esto, RFC 9309, lo pone claramente: un grupo puede nombrar varios agentes antes de que comiencen sus reglas. Especificación RFC 9309 define cómo se interpretan los grupos y los caminos que coinciden.
Así que un archivo que apila treinta nombres de rastreadores en la parte superior de una regla permisiva ha permitido a los treinta. Se lee como una pared y funciona como una puerta abierta. 2.7% de esta muestra hace exactamente eso con al menos un rastreador.
Es por eso que las cifras anteriores se resuelven en lugar de contar. User-agent: GPTBot habría reportado esos archivos como máximo estrictos cuando son lo opuesto, y es el error que cualquiera que revisa su propio archivo por ojo hará.
Qué hacer al respecto, si hay algo que hacer.
Hay una decisión real aquí y no es la que hacen las plantillas.
Tomar opciones separadas para la formación de modelos, el descubrimiento de búsqueda y un usuario pidiendo a un asistente que abra una página. Esos propósitos pueden usar diferentes controles. Revise la terminología actual del proveedor en lugar de asumir cada nombre que contenga “AI” tiene el mismo trabajo.
Por ejemplo, Referencia de Google de arañazo común explica que Google-Extended es un token de producto, no un visitante HTTP separado. Sus usos declarados Gemini difieren de la inclusión y clasificación de Google Search. Una lista de nombres en un archivo no puede mostrar qué solicitudes llegaron a su servidor.
Una política práctica puede permitir que los rastreos relacionados con la búsqueda estén disminuyendo los usos de capacitación especificados. Otro editor puede elegir una restricción más amplia. Ninguna opción garantiza una remisión, pago, acuerdo de licencia o eliminación de material ya utilizado en otros lugares. Nuestra medición no determina qué política es comercialmente mejor para usted.
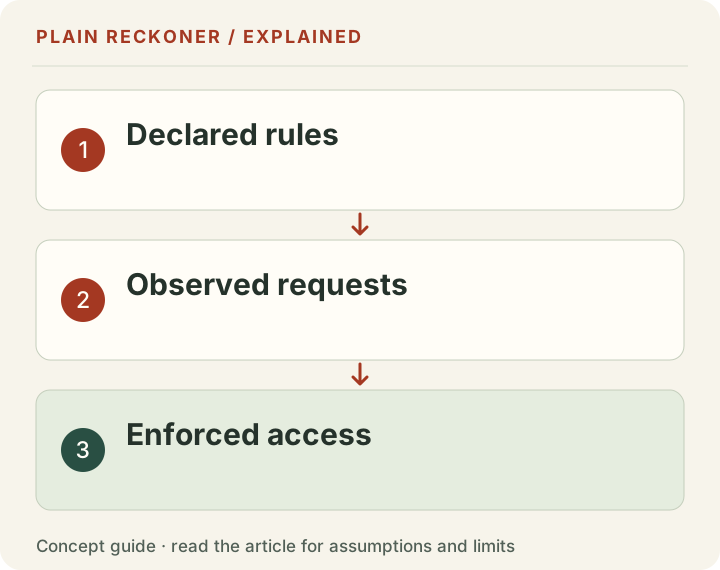
Usar el espacio de trabajo de análisis libre Leer la política pública, identificar quién controla cada sección administrada y mantener una copia antes de cambiar cualquier cosa. Un panel de hospedaje puede hacer cumplir reglas que no son visibles en el archivo, por lo que una revisión completa necesita tanto la declaración como la configuración de servicio real.
Límites
El publicado conjunto de datos sobre las políticas de los rastreadores contiene las tablas históricas y el alcance de la colección. Las referencias actuales del proveedor en este artículo fueron verificadas el 25 de octubre de 2026; eso no refresca el conjunto de datos.
This is 1,020 readable files, from a sample of 1,200 drawn with a fixed starting word from a list of 16,076 domains that two ad networks publish as their own publishers. It describes small, ad-funded content businesses and nothing more. It does not establish the behavior of publishers outside those networks, enterprise news organizations, stores or the wider web. We have not surveyed every other published study or established that all large publishers behave differently.
180 of the 1,200 gave us nothing we could read. They are left out rather than counted as permitting everything, because a refusal — an HTTP 403, which 107 of them gave — is a fact about a firewall and not about a policy, and counting them the other way would have moved the headline in the direction that flatters it. Ten of the 180 answered normally with an empty file; those are left out too, on the same rule the first measurement used, and counting them as silent instead would put the headline share at 76.3% rather than 76.1%.
La lista de la que dibujimos es editores en dos redes de anuncios, no en la web. Un editor sin red de anuncios no está en ella.
Lo que medimos es lo que dicen los archivos, no lo que pasa después
Esto cuenta las reglas escritas en los archivos. No mide si alguna compañía de AI los obedece, y una de ellas dice claramente que no puede.
Las descripciones actuales de los proveedores distinguen la recuperación activada por el usuario del descubrimiento automático. Una regla de desmembramiento escrito puede no ser el control efectivo de cada visita solicitada por el usuario. Eso no cambia el texto observado en los archivos históricos; cambia las consecuencias que podemos inferir razonablemente de él.
En particular, permitir un rastreador de búsqueda no garantiza un enlace o una visita. Bloquear un rastreador de entrenamiento no establece que todo acceso relacionado con la IA ha detenido. Un rastreador también puede ser impedido por un firewall incluso cuando robots.txt parece permisivo. Estas son diferentes observaciones y necesitan pruebas diferentes.
Un cambio de plataforma real que hace útil la distinción
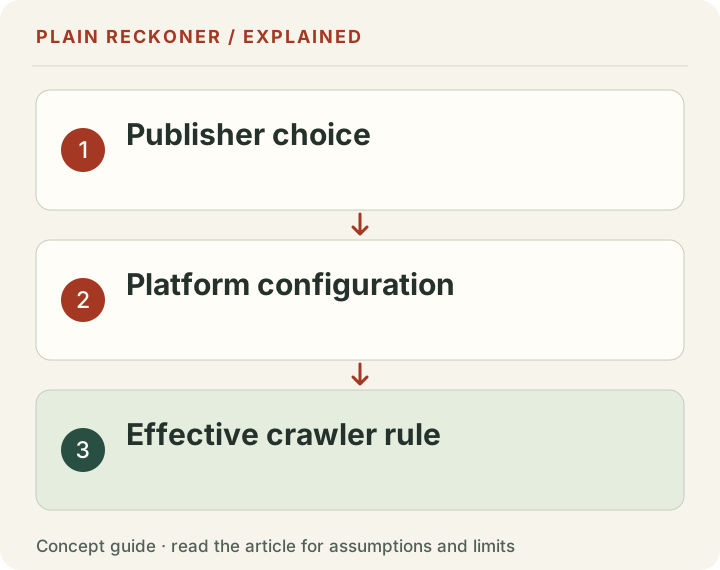
Cloudflare managed robots.txt documentation, actualizado el 22 de octubre de 2026, describe las directivas gestionadas generadas por las preferencias Search, Agent and Training a través de Bot Preference Sync. Este es un ejemplo actual de una plataforma que convierte una preferencia de tablero en texto público. No significa que las firmas de proveedores históricos en nuestro conjunto de datos provengan de esa característica particular.
La lección operativa es inspeccionar el archivo servido, no sólo la copia en el repositorio de código. Una sección gestionada se puede añadir antes del texto de su origen. Por el contrario, una configuración totalmente aceptada puede dejar el archivo de origen sin cambios. La fuente relevante de la verdad para un rastreador es la respuesta que recibe, junto con el comportamiento documentado del proveedor y cualquier regla de acceso forzada por separado.
No eliminar un bloque gestionado ciegamente. Identificar el ajuste que lo produce, decidir si refleja su preferencia, y hacer el cambio en el sistema que lo posee. Editar un archivo de origen puede dejar una sección gestionada por el borde sin tocar. Editar un archivo generado a mano también puede ser revertido por el próximo plugin o actualización de la plataforma.
Prueba una política declarada sin reclamar un resultado de tráfico
Comience con una URL pública que los lectores deben ser capaces de acceder. Guardar la respuesta actual de los robots, su estado, la fecha y el sistema que se cree para manejarlo. Revise la ruta de la raíz y una ruta de artículo real. Un hallazgo de nivel raíz es útil, pero una regla de camino más estrecha puede cambiar la respuesta para una página individual.
A continuación, escriba el propósito que está tratando de permitir o restringir. Si el objetivo es el descubrimiento de búsqueda, utilice el control relacionado con la búsqueda del proveedor. Si el objetivo es una opción de entrenamiento específica, utilice el control de entrenamiento documentado. Evite traducir un objetivo de negocio amplio directamente en una lista larga copiada de un repositorio aleatorio.
Lea el resultado como un rastreador lo haría. Seleccione el grupo de agente pertinente, aplique sus reglas de ruta y note cualquier incertidumbre. Un archivo que contiene un nombre no es automáticamente un bloque. Una ruta permitida no es prueba de que se hizo una solicitud. Preserve tanto la respuesta cruda como su interpretación para que alguien más pueda reproducir el cheque.
Después de un cambio, busque el archivo servido de nuevo. Compruebe las secciones gestionadas duplicadas y restricciones no deseadas en los rastreadores de búsqueda ordinarios. Pídale al propietario de la plataforma que le explique una regla que no puede rastrear. No promete un cambio de clasificación inmediato: un rastreador todavía necesita volver a revisar, y el descubrimiento no asegura la selección para una respuesta.
Para la aplicación efectiva, inspeccionar el servidor o los registros de solicitud de bordes con el método apropiado de verificación de bots. Una cadena de agente de usuario puede ser imitada. Referencia común de Crawl CCBot La misma distinción general importa cada vez que un tráfico de etiquetas dashboard utiliza sólo un nombre de visitante reclamado.
Mantener funciones de proveedor en un registro de mantenimiento pequeño
Grabar el nombre de bot, el propósito declarado, la documentación oficial, la fecha comprobada, la decisión actual y la persona o sistema responsable de cambiarlo. Mantenga la observación histórica en una columna separada. Eso evita que la nueva terminología de un proveedor reescriba silenciosamente lo que una vieja muestra midió.
Guía de los rastreadores de Antrópico distingue la colección de modelos de desarrollo, la recuperación dirigida por el usuario y el descubrimiento de búsqueda. Perplejidad guía de rastreadores También separa su rastreador de búsqueda de un fetcher dirigido por el usuario. Sus descripciones actuales son controles útiles para consultar, no evidencia que cada solicitud histórica obedeció a un archivo.
Revise el registro cuando un proveedor cambia su documentación, cuando su plataforma de hospedaje cambia la configuración administrada, o cuando se observan solicitudes no coinciden con su expectativa. No trate una lista de antiguos rastreadores como un límite de seguridad permanente. Una lista pequeña y fechada de opciones que usted entiende es más útil que una larga lista sin propietario.
El siguiente paso es inspeccionar su propia política declarada e identificar una incertidumbre que vale la pena resolver. Nuestra muestra histórica puede demostrar que existen declaraciones de aspecto inconsistente. No puede decidir su posición de licencia, predecir una visita, o sustituir la evidencia del sistema que realmente sirve sus páginas.